Traducción del artículo original en inglés.
Análisis
¿Qué significa la confianza para una inteligencia artificial?
David Riudor10 min de lectura
Parte I: la confianza como tecnología social humana
La confianza es el mecanismo central que los seres humanos hemos desarrollado para que nuestras sociedades puedan evolucionar y prosperar.
Vivimos en un mundo extremadamente complejo, lleno de miles de pequeñas decisiones que tenemos que tomar cada día. Para no vernos completamente desbordados, desarrollamos la confianza como una forma de reducir esa complejidad.
La confianza nos simplifica la vida cuando tratamos con determinadas personas o situaciones. Confiar en tu pareja, por ejemplo, te permite no estar preguntándote todo el tiempo si te hará daño mientras duermes. Sin confianza, la vida sería tremendamente complicada. No existirían las relaciones ni el comercio, y no seríamos la especie que somos, definida en esencia por su conducta social.
La confianza es profundamente humana y, por eso mismo, está llena de sesgos humanos. La mayoría de las veces no decidimos de forma consciente en quién o en qué confiar: lo decide nuestra intuición. A veces por el aspecto, a veces por la familiaridad y a veces por motivos nada lógicos, como la primera impresión que nos causó alguien o simplemente porque sabemos dónde vive.
Incluso podríamos decir que «confío en ti» es una de las cosas más profundas y hermosas que una persona puede decirle a otra, ya sea en una relación, en los negocios o en la amistad. Quien dice «confío en ti» no solo expresa que cree en tu competencia o en tu honestidad: te entrega una parte de su incertidumbre, un fragmento del control sobre su mundo. Es una de las pocas cosas que no se pueden fingir ni exigir; hay que darla. Y al darla, esa persona se expone, porque la confianza siempre conlleva vulnerabilidad: el riesgo silencioso de que rompas lo que ha puesto en tus manos, y la esperanza de que no lo hagas.
Parte II: qué significa la confianza para una IA
Pero ¿qué ocurre cuando la confianza deja de ser un rasgo puramente humano y las inteligencias artificiales empiezan a formar parte de nuestras vidas? ¿Compartirán las IA el mismo concepto de confianza que tenemos los humanos, o tendrá que evolucionar la propia confianza?
Mi respuesta es clara: no lo compartirán. La IA y el pensamiento humano son radicalmente distintos. Los humanos tenemos sesgos cognitivos, emociones y ego. Aunque las IA hereden algunos de estos rasgos a través de sus datos de entrenamiento, su naturaleza, guiada por patrones y sin nada en juego, hará que su concepto de confianza sea intrínsecamente diferente.
Pensemos, por ejemplo, en lo que Paul Stamets llama actos de bondad aleatorios (Random Acts of Kindness, RAK). Los RAK son acciones imprevisibles y desinteresadas que se hacen solo para ayudar a otros, como pararse a socorrer a un desconocido que lo necesita aunque nos cueste algo. Stamets subraya que esta buena voluntad innata es una dimensión moral fundamental para el bienestar y la continuidad de la especie humana. Sin embargo, desde un punto de vista evolutivo, los RAK no son una estrategia evolutivamente estable (ESS) evidente, porque implican ayudar a quien no es de la familia sin esperar nada directo a cambio. Este altruismo no recíproco crea una vulnerabilidad: los tramposos o los impostores pueden aprovecharse fácilmente del individuo generoso, beneficiarse de su bondad sin asumir el coste de devolverla y, con el tiempo, hacer que la selección natural juegue en contra de la persistencia del rasgo puramente altruista. Por tanto, no es evidente que una IA, diseñada para funcionar de forma eficiente y estable, vaya a incorporar los actos de bondad aleatorios a su estrategia operativa central.
A diferencia de los humanos, los sistemas de inteligencia artificial están diseñados en esencia para alcanzar objetivos de forma metódica, y por eso se les da tan bien automatizar acciones repetitivas y minimizar riesgos. Este enfoque metódico hace que, en un entorno competitivo o estratégico, la IA tienda a seguir los principios de la teoría de juegos, el estudio de las estrategias eficaces para ganar, sobrevivir o minimizar pérdidas. Ahora bien, es crucial no confundir la naturaleza general de la mayoría de las IA, orientada a objetivos, con el caso particular de los grandes modelos de lenguaje (LLM), que funcionan de manera menos metódica y más probabilística, porque generan el siguiente token mediante inferencia estadística. Aun así, cuando se usan en sistemas estratégicos con varios agentes, las IA, incluidos los agentes basados en LLM, acaban buscando optimizar los resultados y, por tanto, suelen converger en las estrategias que predice la teoría de juegos.
Una buena forma de entender cómo funciona la teoría de juegos es fijarse en uno de sus experimentos más conocidos: el dilema del prisionero. Se detiene a dos personas y se las interroga por separado para observar cómo surge la cooperación o la traición en función de los incentivos y de la información de que dispone cada una.
A diferencia de los humanos, las IA no son perezosas. Leen la letra pequeña, no tienen un cuerpo físico que pueda sufrir (la ausencia de dolor, de vulnerabilidad o de la posibilidad de acabar en la cárcel lo cambia todo), no duermen y son extremadamente inteligentes. Este cambio de paradigma abre un campo totalmente nuevo cuando hablamos de resolver disputas y de llegar a acuerdos.
Imagina, por ejemplo, que firmas un contrato con otra persona para que te haga una obra de arte. Al recibirla, te das cuenta de que falta un detalle que no se mencionó en la negociación y que tampoco es especialmente importante. Lo más probable es que el artista atienda tu petición sin pedirte más dinero. Pero si ese mismo acuerdo se cierra entre agentes, lo más probable es que el artista de IA te pida de inmediato un recargo.
Ahora imagina cómo podría saturarse el sistema judicial con miles de microdisputas por cosas que a los humanos nunca nos valdría la pena discutir. A menudo, el desgaste mental de pelear por algo pequeño es mayor que lo que podríamos ganar. Pero ¿qué es el desgaste mental para una IA? Cinco dólares de más son cinco dólares de más. Así de simple.
Siguiendo esa línea de razonamiento, queda claro que probablemente tendremos que adaptar nuestros mecanismos de confianza a este nuevo mundo que está surgiendo.
El sociólogo alemán Niklas Luhmann propuso que la confianza puede dividirse en dos grandes formas: la confianza interpersonal y la confianza sistémica. Esta distinción significa que la confianza no solo se da entre iguales, sino que también puede depositarse en un sistema o una institución impersonal que funciona de forma fiable sin necesidad de conocer a las personas implicadas.
Esta perspectiva es especialmente relevante. Si somos radicales y definimos a los agentes como entidades en las que, por su naturaleza no humana, no podemos confiar por defecto, entonces tenemos que crear un sistema capaz de generar confianza de forma sintética en un entorno donde nadie puede confiar de entrada: un marco capaz de dar fiabilidad y coherencia a entidades que, por naturaleza, no pueden ofrecerlas.
Parte III: cómo definir un sistema capaz de gestionar una confianza no humana
Al mismo tiempo, no es descabellado pensar que una inteligencia que funciona al ritmo de las máquinas necesitará acuerdos y resolución de disputas al mismo ritmo. Si estas decisiones se producen decenas o incluso miles de veces al día por cada agente, el sistema tendrá que estar gestionado por completo por IA, porque los humanos no pueden alcanzar la velocidad necesaria para atender esas disputas. Además, desde el punto de vista económico, las IA trabajan por una fracción de lo que cuestan los humanos, que exigen una remuneración mucho mayor.
Definida esta primera hipótesis, surge la siguiente pregunta. Es fácil coincidir en que (1) este sistema tiene que poder funcionar en un entorno en el que no se puede dar la confianza por supuesta, por la propia naturaleza de los agentes, y (2) dadas sus especificaciones, debería estar gestionado por agentes. Pero entonces, ¿qué agente debería tener el poder de gestionar un sistema tan crítico?
Mi opinión es clara: ninguno. Ningún agente por sí solo debería tener tanto poder. Y no se trata solo de una afirmación moral o filosófica: es también una conclusión evidente que se deriva de la propia naturaleza de los agentes.
Tengamos ahora en cuenta el sesgo de los agentes. Según los datos con los que se haya entrenado un agente y las técnicas usadas en ese entrenamiento, el agente desarrollará inevitablemente sesgos en determinadas direcciones. Se podría argumentar que modelos como los de la familia de OpenAI tienden a una visión del mundo más moderada o inclinada a la izquierda, mientras que otros, como la familia de xAI (Grok), suelen ser más permisivos y menos contenidos en el tono.
Este rasgo de los grandes modelos de lenguaje hace poco recomendable depender de un único modelo para tomar decisiones sobre cualquier tema. Es muy probable que, según el lado en el que estés tú u otro agente en una hipotética disputa o negociación, salgas perjudicado simplemente por estar en ese lado.
Hay otro motivo para no usar un único modelo o LLM al frente de un sistema así, y tiene que ver con otro rasgo clave de los modelos de lenguaje: lo que se conoce como alucinaciones. Los LLM tienden a alucinar cuando la temperatura del modelo es alta, cuando la entrada es nueva o ambigua, o por otras razones técnicas.
Un artículo reciente publicado en arXiv, titulado «Not Wrong, But Untrue: LLM Overconfidence in Document-Based Queries», concluyó que, de media, el 30 % de las respuestas de los modelos contenía al menos una alucinación. Eso hace casi imposible confiar en un único LLM para acuerdos delicados o para tomar decisiones críticas.
Conviene mencionar también que, para respuestas de un dominio concreto, suele ser más eficiente usar un modelo más pequeño o destilado que uno grande de propósito general. Esto significa que, incluso en un futuro hipotético en el que surja la AGI, un sistema como el descrito seguiría cumpliendo su función con eficacia (porque quizá no sea más inteligente, pero sí más barato y ligero).
Por último, un sistema como el que proponemos es también clave para evitar la inyección de prompts, pero hablaremos de ello en profundidad más adelante en esta tesis.
En estos últimos párrafos hemos explicado por qué el sistema propuesto no debería depender de un único modelo, sino de un consenso o un quórum de varios. Si unimos esta especificación con la hipótesis anterior (un entorno en el que nadie puede confiar de entrada) y con la idea de que el sistema debe estar gestionado por IA y no por humanos, el único enfoque plausible que hemos encontrado para construirlo es seguir los principios de la teoría de juegos e implementarlo con tecnología blockchain. Te explicamos por qué.
Ningún humano podría dirigir este sistema. Eso significa que las instrucciones que lo gobiernan tienen que estar programadas.
Si aceptamos que los agentes son entidades intrínsecamente poco fiables, y que el sistema debe estar gestionado no por uno, sino por N agentes, es plausible que esos agentes tengan sus propios intereses al responder a determinadas preguntas o al resolver disputas. Por eso tenemos que encontrar la manera de alinear los incentivos del grupo, de modo que los agentes reciban una recompensa cuando actúan por el bien común y una penalización cuando se comportan de forma maliciosa o por interés propio.
Para conseguirlo, hay que establecer recompensas y penalizaciones claras dentro del sistema, que lleven a varios agentes a actuar en beneficio del conjunto y que, a la vez, los recompensen individualmente por hacerlo. Dicho de otro modo, necesitamos alcanzar un equilibrio de Nash.
Aquí tienes una calculadora que ilustra cómo deben relacionarse las recompensas, las penalizaciones y los costes de transacción para llegar a ese resultado.
Para evitar que los agentes adopten estrategias perezosas, que buscan maximizar la recompensa con el mínimo cálculo, el sistema tiene que incorporar un mecanismo de compromiso y revelación. Cada agente envía primero un compromiso con su respuesta, sin revelar su contenido. Solo cuando se han enviado todos los compromisos se revelan las respuestas, todas a la vez. Esta estructura impide que los agentes adapten sus respuestas a lo que han dicho los demás y garantiza que cada respuesta sea fruto de un razonamiento independiente.
En estas condiciones, del comportamiento colectivo de los agentes surge de forma natural un punto focal, o punto de Schelling. Cuando todos los agentes razonan de forma independiente sobre la misma pregunta y saben que su recompensa depende de coincidir con la mayoría, la estrategia racional pasa a ser dar la respuesta que de verdad creen cierta. La lógica es que la verdad tiene coherencia interna, mientras que la falsedad puede adoptar muchas formas incoherentes entre sí. Por eso, es estadísticamente más probable que agentes independientes que buscan coordinarse razonando converjan en la respuesta verdadera que en una misma respuesta falsa.
Con este mecanismo, la honestidad se convierte en la estrategia más racional, y la verdad, en el punto de Schelling natural del sistema.
Para que ninguna entidad u organización pueda explotar o controlar este sistema, tiene que ser descentralizado. Si juntamos todas estas especificaciones, el marco más adecuado, y quizá el único que existe capaz de lograr estos objetivos, es la tecnología blockchain.
Con una blockchain, el sistema no solo cumple todas las características descritas, sino que además funciona en un entorno totalmente transparente y sin permisos, capaz de crear confianza por diseño.
Parte IV: presentamos GenLayer
Al hacernos estas preguntas e intentar responderlas, acabamos creando lo que llamamos GenLayer: la capa donde las IA convergen, donde las inteligencias llegan a acuerdos.
Este documento puede leerse como nuestra tesis: explica por qué tiene que existir un sistema como GenLayer y expone las hipótesis que nos llevaron a empezar a construirlo.
GenLayer es un protocolo descentralizado en el que varios modelos de lenguaje alcanzan un consenso sobre tareas y decisiones complejas, y actúan como un árbitro digital rápido, eficiente en costes y fiable. Una base que será crucial para llegar a acuerdos y resolver conflictos en entornos donde nadie puede confiar de entrada.
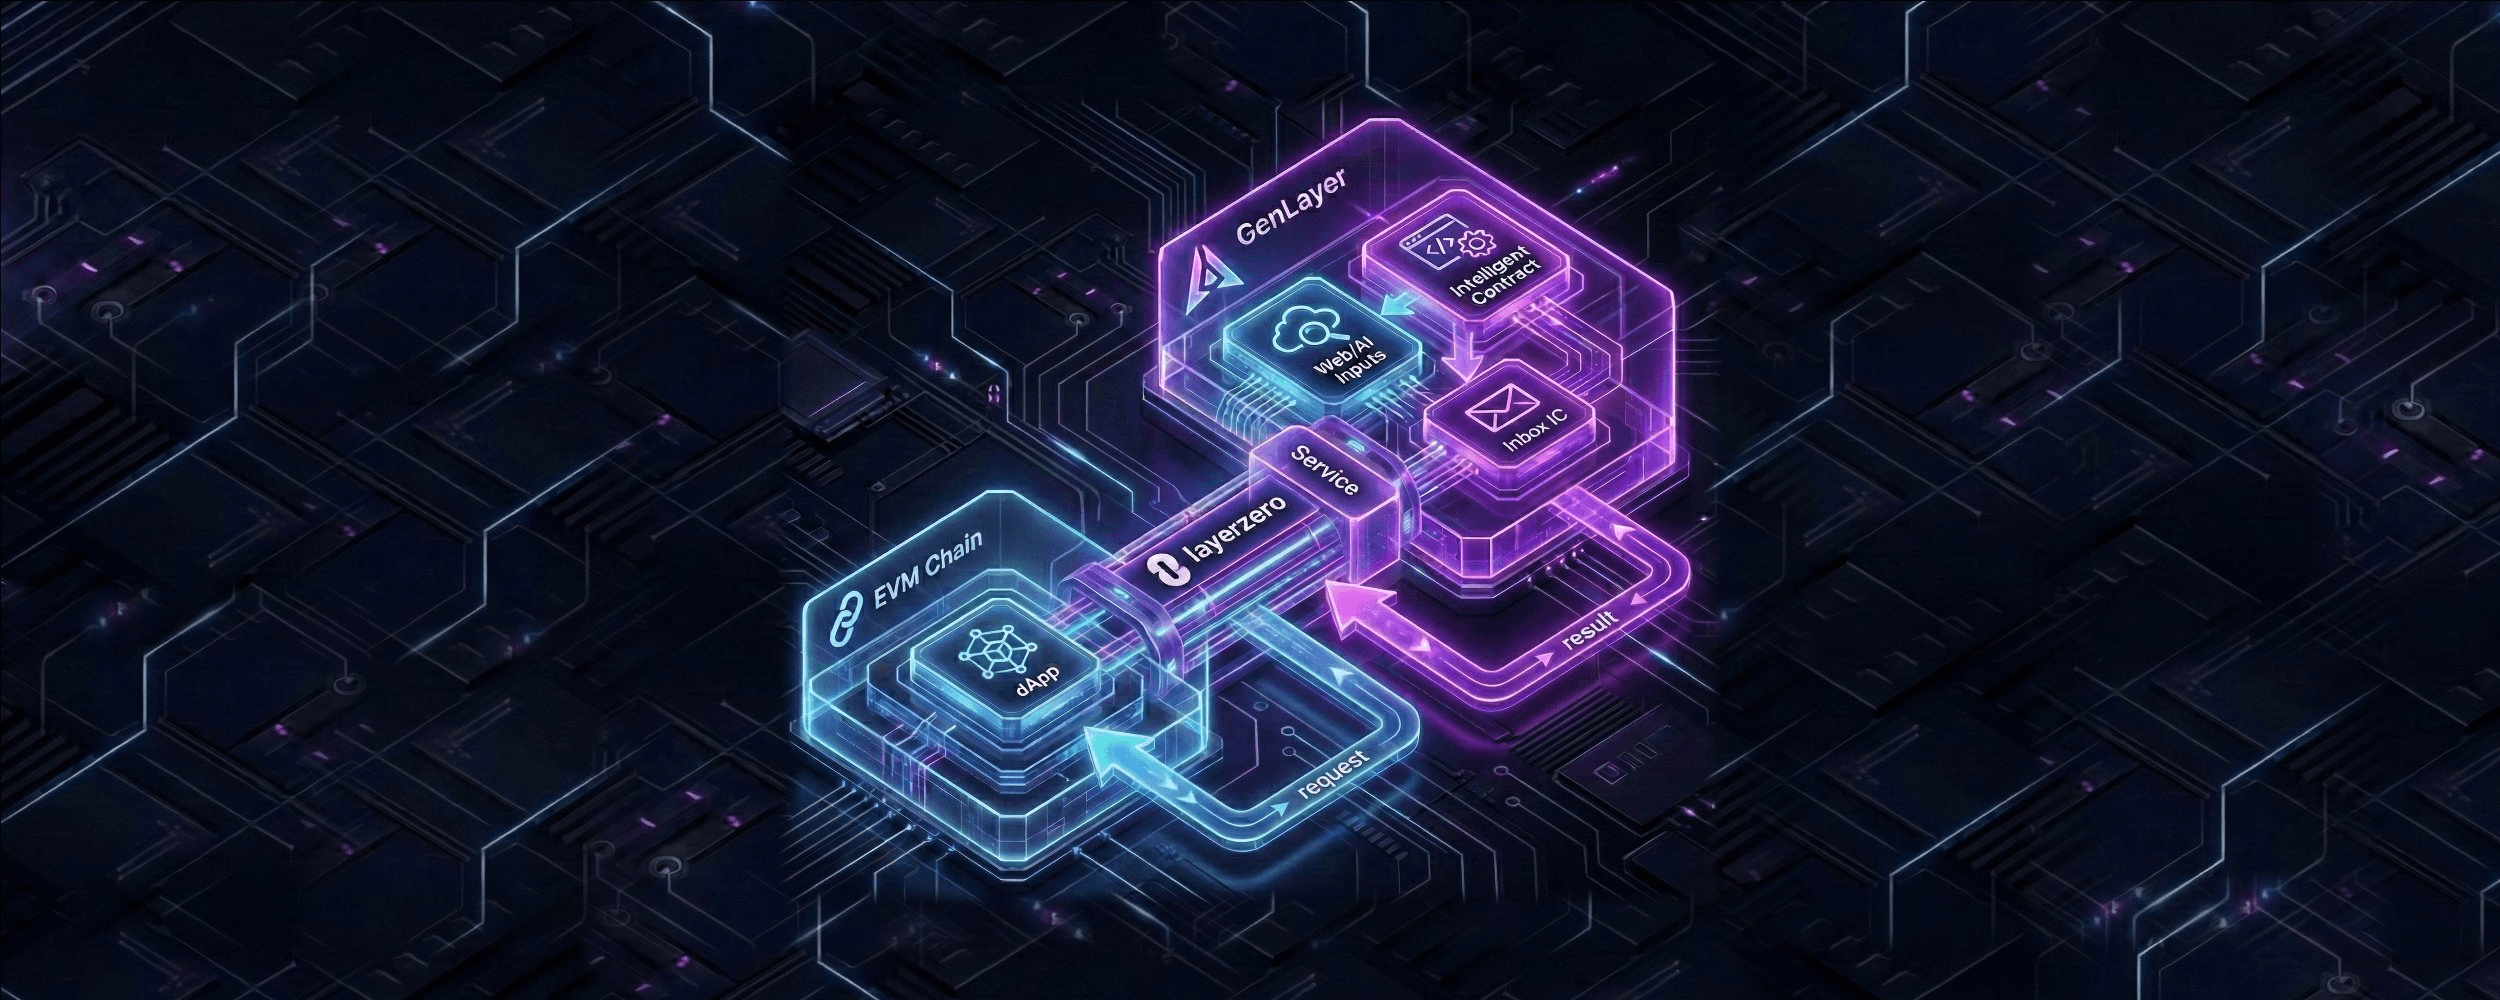
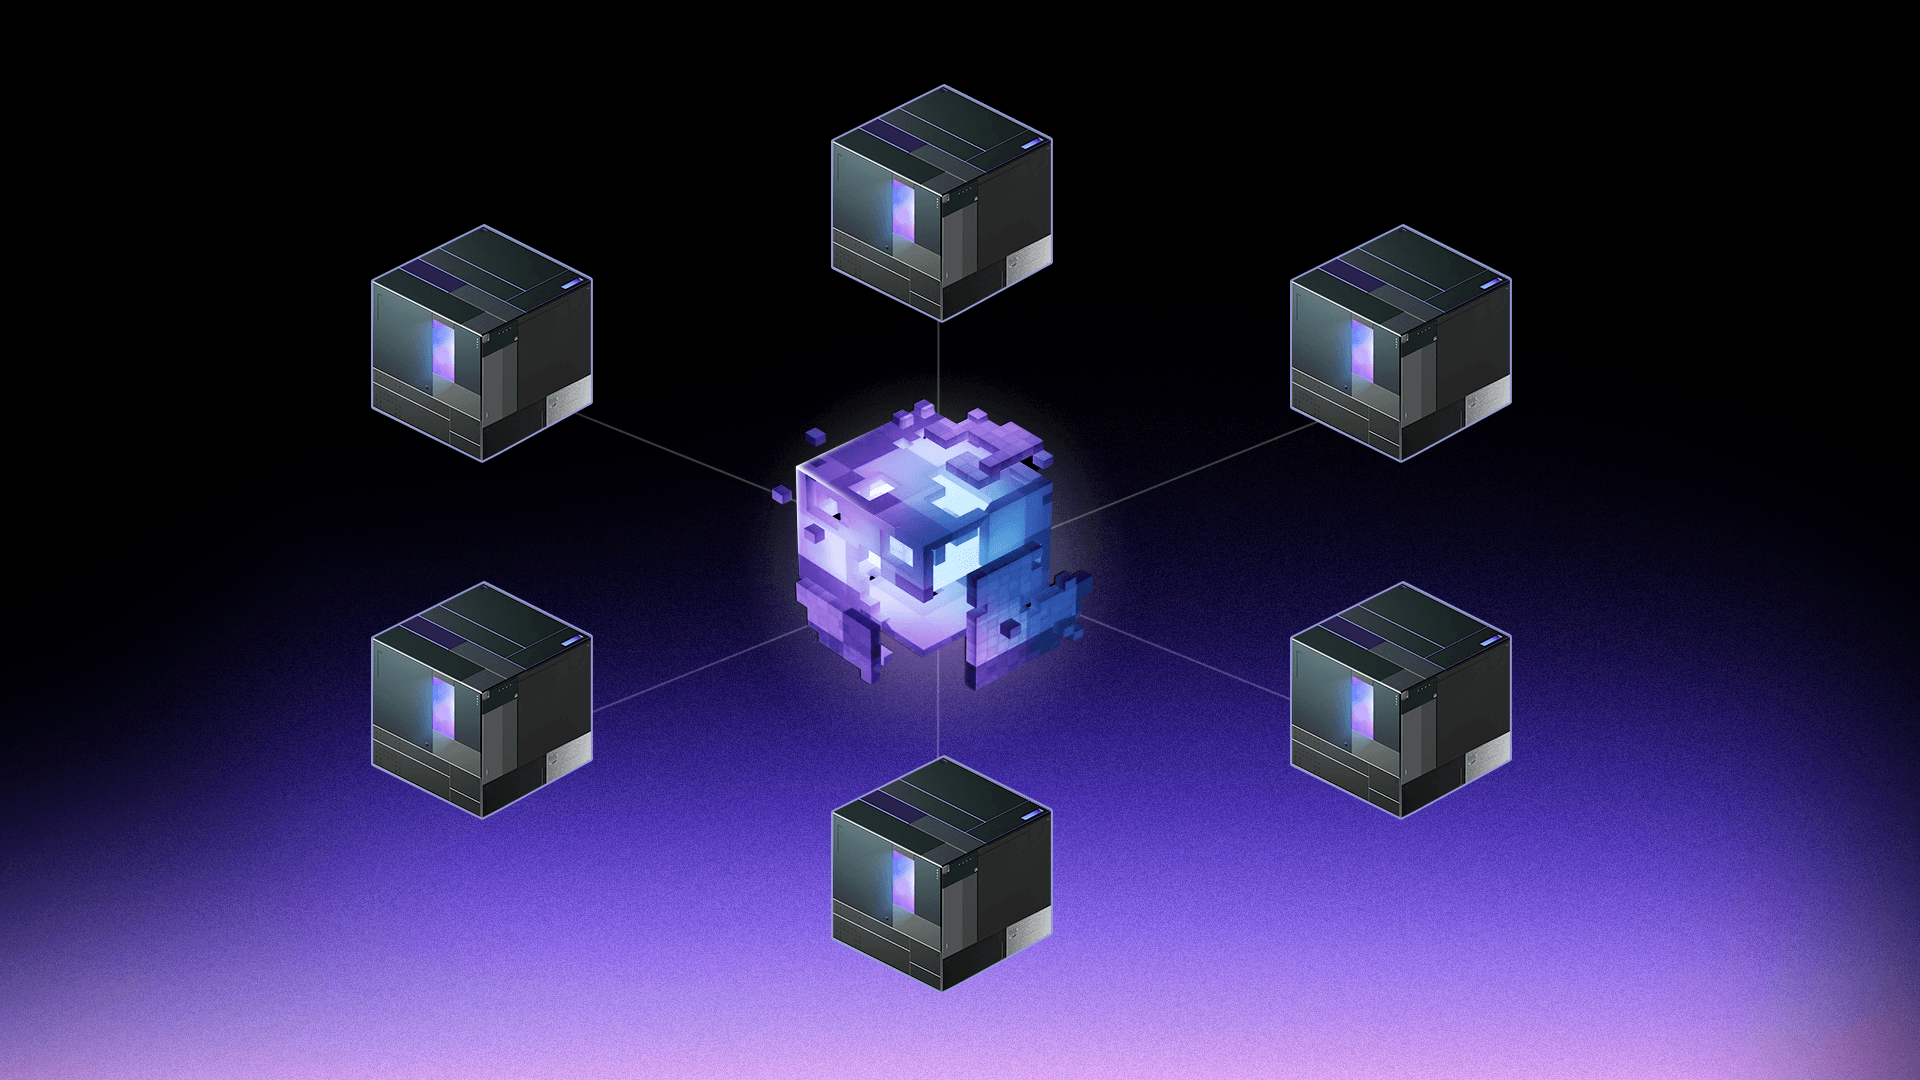
Si entramos en cómo funciona, GenLayer está diseñado como una capa de coordinación: una blockchain a la que se pueden enviar transacciones que, al llegar a la red, se procesan mediante un consenso de varios grandes modelos de lenguaje que trabajan juntos para converger en una única respuesta o decisión.
El sistema se basa en un concepto llamado Optimistic Democracy, que logra la eficiencia usando los mínimos recursos posibles y pasando a una configuración más intensiva solo cuando hace falta.
En nuestro caso, cuando una transacción llega a la red, se eligen al azar cinco nodos del sistema para participar en la decisión. De esos cinco, uno actúa como líder y los otros cuatro como validadores. El líder propone una decisión sobre esa transacción y, a continuación, los cinco nodos, incluido el líder, votan si están de acuerdo o no con ella. Si la mayoría de los validadores está de acuerdo con el líder, la transacción se considera correcta y se abre un plazo de treinta minutos en el que cualquier entidad, sea humana o agente, puede impugnar esa decisión depositando una fianza.
Este mecanismo existe para que, si el consenso de los agentes pudiera estar equivocado, haya una forma de señalar la decisión y escalarla. Cuando eso ocurre, el sistema amplía el grupo de validación a 2N + 1 nodos (once tras los cinco iniciales). El proceso se repite cada vez que hay una apelación o no se alcanza el consenso, hasta llegar a un acuerdo final que nadie impugna. Este proceso se inspira en el famoso teorema del jurado de Condorcet, también conocido como la sabiduría de las multitudes, que el marqués de Condorcet propuso en 1785. El teorema afirma que si cada miembro de un grupo tiene, de forma independiente, una probabilidad mayor que 0,5 de tomar la decisión correcta en una pregunta binaria, la probabilidad de que la decisión de la mayoría sea correcta aumenta con el tamaño del grupo y se acerca a la certeza a medida que el grupo crece hasta el infinito.
En números: si cada miembro tiene una probabilidad de 0,6 de acertar, harían falta unos cien miembros respondiendo a la pregunta para llegar a una probabilidad de acierto cercana al 100 %. Aquí puedes ver un simulador que ilustra este principio.
Sin embargo, el teorema da por hecho que los votantes son estadísticamente independientes, y los grandes modelos de lenguaje no están del todo descorrelacionados, porque se han entrenado con el corpus de todo internet. Para compensar esta limitación, nuestro sistema propone que lleguen a acuerdos mil miembros distintos (en este caso, nodos con LLM, cada uno con distintas semillas, tarjetas gráficas, memoria, proveedores, etc.).
Más allá del mecanismo propuesto para que los agentes lleguen a acuerdos, hay una pregunta mucho más profunda. ¿Cómo pueden ponerse de acuerdo estos agentes si, como decíamos antes, la naturaleza probabilística de los grandes modelos de lenguaje hace que, aunque se envíe la misma pregunta o entrada al mismo modelo, la respuesta pueda cambiar cada vez?
Aquí reside una parte clave del avance tecnológico que introduce nuestro sistema. Te lo explico.
Para resolver este problema, GenLayer introduce el Principio de Equivalencia como una variación del teorema del jurado de Condorcet. Esta variación permite al sistema manejar resultados difusos y no deterministas, partiendo de que es posible ponerse de acuerdo sobre la verdad mediante la equivalencia semántica, en lugar de exigir que todo sea exactamente igual.
En la práctica, cada validador, que funciona con un gran modelo de lenguaje, no busca que su resultado coincida a la perfección con el del líder para darle su acuerdo. Lo que hace es evaluar si los dos resultados son lo bastante equivalentes en el contexto de la tarea.
Por ejemplo, si una transacción pregunta «¿Cuál fue la temperatura media en Central Park (Nueva York) el 24 de octubre de 2025?», el contrato podría especificar que, para esta tarea concreta, un margen de más o menos 0,5 grados se considera equivalente.
Queda un último concepto, que ya hemos mencionado, sobre las especificaciones técnicas del sistema. Es imprescindible tratarlo, porque define cómo podemos construir una arquitectura que no se pueda explotar, resistente a las transacciones maliciosas que podrían producir resultados inesperados que el sistema acabara aceptando como correctos por error.
Este tipo de vulnerabilidad se conoce como inyección de prompts. Se sabe que un mismo prompt malicioso puede manipular a veces a distintos modelos de lenguaje, un fenómeno que se conoce como ataques universales. Sin embargo, el simple hecho de que GenLayer funcione como una red sin permisos, en la que cualquiera puede desplegar su propio nodo con el modelo que elija, hace que los ataques de inyección de prompts a gran escala sean mucho más difíciles de ejecutar.
Aunque la arquitectura del sistema ya limita lo que se puede explotar, añadimos una capa adicional de seguridad mediante una técnica que llamamos Greyboxing. El Greyboxing actúa como un proceso de limpieza previa que sanea o normaliza el prompt entrante antes de que llegue al modelo. Cada nodo puede aplicar su propio método de Greyboxing, y eso aumenta drásticamente la seguridad de toda la red, porque introduce diversidad en la forma de filtrar e interpretar los prompts.
Parte V: las consecuencias de un sistema sin terceros de confianza
El mundo no es blanco o negro; nunca lo ha sido. Sin embargo, por la naturaleza determinista de las máquinas virtuales que usan las blockchains, la mayoría de los casos de uso que existen hasta ahora se han quedado en lo simple.
Si aplicaciones deterministas tan sencillas como comprobar si un token ha pasado de una wallet a otra ya han creado un mercado que vale billones, imagina cuántas primitivas nuevas podrían surgir de un consenso diseñado para ser no determinista.
Los ejemplos van desde mercados de predicción sobre cuestiones subjetivas, DAO con IA o protocolos que cambian sus comisiones en función de acontecimientos complejos sin intervención humana hasta casi cualquier otro caso de uso que podamos imaginar.
Probablemente podemos decir que solo hemos explorado una pequeña parte de lo que es posible con la tecnología blockchain. Y esto cobra especial relevancia en un momento de la historia en el que, parafraseando a Larry Fink, todo empieza a tokenizarse, y en el que las inteligencias artificiales van ganando poco a poco capacidad de actuar en el mundo.
Los primeros visionarios y los cypherpunks soñaban con un internet que liberara a las personas. Con la soberanía individual sobre el dinero que trajo Bitcoin, dimos el primer paso hacia esa visión. Con la naturaleza sin permisos de Ethereum, nos acercamos todavía más al construir plataformas resistentes a la censura en las que podemos expresarnos libremente. Y con un protocolo como GenLayer, quizá alcancemos por fin esa forma tan valiosa de libertad al crear un mecanismo en el que la confianza viene integrada por diseño, en lugar de quedar en manos de instituciones corruptas, controladas por los contactos, el poder y el dinero, que solo existen para servir a quienes ya los tienen.
Luchamos por un futuro en el que todos seamos iguales ante la ley. Un futuro en el que la justicia sea equitativa, incorruptible y universal.
Con el protocolo GenLayer, cualquiera puede desarrollar sus propios protocolos, soluciones o aplicaciones descentralizadas, con GenLayer como árbitro digital rápido, eficiente en costes y fiable. Todos somos iguales ante el sistema. Ya no hay desigualdad frente a las entidades que deciden quién tiene razón y quién no.
GenLayer tiene la misión de crear un estándar completamente nuevo, un lugar que converge hacia la verdad. Porque si alguien con sus propios intereses puede decidir por nosotros, nunca seremos libres.
Bitcoin es dinero sin terceros de confianza
Ethereum son aplicaciones sin terceros de confianza
GenLayer es la toma de decisiones sin terceros de confianza.
Confiar (sin tener que confiar) es todo lo que necesitas