Bu yazı İngilizce orijinalinden çevrildi.
Görüşler
Yapay zekâ için güven ne anlama geliyor?
David Riudor10 dk okuma
I. Bölüm: İnsana özgü bir toplumsal teknoloji olarak güven
Güven, toplumlarımız gelişip serpilebilsin diye biz insanların ortaya koyduğu temel mekanizmadır.
Dünyamız son derece karmaşık ve her gün vermemiz gereken binlerce küçük kararla dolu. Bu yükün altında ezilmemek için güveni, dünyanın karmaşıklığını azaltan bir mekanizma olarak geliştirdik.
Güven, belirli kişilerle ya da durumlarla karşı karşıya kaldığımızda hayatı basitleştirmenin bir yoludur. Örneğin partnerinize güvendiğiniz için, siz uyurken size zarar verip vermeyeceğini sürekli düşünmek zorunda kalmazsınız. Güven olmasaydı hayat son derece karmaşık olurdu. Ne ilişkiler ne de ticaret var olabilirdi; özünde toplumsal davranışlarıyla tanımlanan bir tür olarak bugünkü hâlimize de hiç ulaşamazdık.
Güven derinden insanidir, bu yüzden de insani önyargılarla doludur. Çoğu zaman kime ya da neye güveneceğimize bilinçli olarak karar vermeyiz; bu kararı bizim yerimize sezgilerimiz verir. Kimi zaman dış görünüş, kimi zaman tanıdıklık, kimi zaman da mantıksız nedenler belirleyici olur: birinin üzerimizde bıraktığı ilk izlenim ya da yalnızca o kişinin nerede oturduğunu biliyor olmamız gibi.
Hatta “Sana güveniyorum” sözlerinin, ister bir ilişkide ister iş hayatında ister dostlukta olsun, bir insanın bir başkasına söyleyebileceği en derin ve en güzel şeylerden biri olduğunu söyleyebiliriz. Biri size “Sana güveniyorum” dediğinde yalnızca yetkinliğinize ya da dürüstlüğünüze inandığını dile getirmiyordur; belirsizliğinin bir parçasını, kendi dünyası üzerindeki kontrolün bir kırıntısını size teslim ediyordur. Güven, taklit edilemeyen ve talep edilemeyen ender şeylerden biridir; ancak verilebilir. Bunu yaparken insan kendini savunmasız bırakır, çünkü güven her zaman bir kırılganlık taşır: elinize bıraktığı şeyi kırabileceğiniz sessiz riski ve kırmayacağınıza dair umudu.
II. Bölüm: Bir yapay zekâ için güvenin anlamı
Peki güven yalnızca insana özgü bir özellik olmaktan çıktığında ve yapay zekâlar hayatımıza katılmaya başladığında ne olur? Yapay zekâlar biz insanların benimsediği güven kavramını paylaşacak mı, yoksa güvenin kendisi mi evrilmek zorunda kalacak?
Benim yanıtım net: hayır. Yapay zekâ ile insan düşüncesi temelden farklıdır. İnsanların bilişsel önyargıları, duyguları ve egoları vardır. Yapay zekâlar bu özelliklerin bir kısmını eğitim verileri aracılığıyla devralsa bile, örüntülerle çalışan ve kaybedecek hiçbir şeyi olmayan doğaları, onların güven kavramını özünde farklı kılacaktır.
Paul Stamets'in Rastgele İyilik Eylemleri (Random Acts of Kindness, RAK) adını verdiği davranışları ele alalım. RAK, yalnızca başkalarına yardım etmek için yapılan, öngörülemeyen ve karşılık beklemeyen eylemlerdir: kişisel bir bedeli olsa bile durup yardıma muhtaç bir yabancıya el uzatmak gibi. Stamets'e göre bu doğuştan gelen iyi niyet, insan türünün esenliği ve sürekliliği için vazgeçilmez, kritik bir ahlaki boyuttur. Ne var ki evrim açısından bakıldığında RAK bariz bir evrimsel olarak kararlı strateji (ESS) sayılmaz, çünkü doğrudan bir karşılık beklemeden akraba olmayanlara yardım etmeyi gerektirir. Bu karşılıksız özgecilik bir zaaf yaratır: Hileciler ya da sahtekârlar cömert bireyden kolayca yararlanabilir, iyiliğin tadını çıkarıp karşılığını ödemenin bedeline hiç katlanmayabilir. Böylece zaman içinde seçilim, saf özgecil özelliğin sürmesinin aleyhine işler. Dolayısıyla verimli ve kararlı çalışmak üzere tasarlanmış bir yapay zekânın Rastgele İyilik Eylemlerini temel işleyiş stratejisine katacağı hiç de açık değildir.
Yapay zekâ sistemleri, insanlardan farklı olarak, temelde hedeflere yöntemli biçimde ulaşmak üzere tasarlanır; bu da onları tekrarlayan işleri otomatikleştirmede ve riski en aza indirmede usta kılar. Bu yöntemli yaklaşım yüzünden yapay zekâ, rekabetçi ya da stratejik bir ortamda oyun teorisinin ilkelerini izleme eğilimindedir. Oyun teorisi, kazanmak, hayatta kalmak ya da kayıpları en aza indirmek için etkili stratejileri inceleyen alandır. Ancak yapay zekâların çoğundaki bu genel, hedefe yönelik doğayı, özel bir alt durum olan büyük dil modelleriyle (LLM'ler) karıştırmamak çok önemlidir. LLM'ler daha az yöntemli, daha olasılıksal çalışır ve bir sonraki tokenı üretmek için istatistiksel çıkarıma dayanır. Yine de stratejik çok ajanlı sistemlerde kullanıldığında LLM tabanlı ajanlar dâhil yapay zekâ nihayetinde en iyi sonucu elde etmeye yönelir ve bu yüzden genellikle oyun teorisinin öngördüğü stratejilerde buluşur.
Oyun teorisinin nasıl işlediğini anlamanın iyi bir yolu, en bilinen deneylerinden birine, Mahkûm İkilemi'ne bakmaktır. Bu deneyde iki kişi gözaltına alınır ve ayrı ayrı sorgulanır; amaç, her birinin elindeki teşviklere ve bilgilere göre iş birliğinin ya da ihanetin nasıl ortaya çıktığını gözlemlemektir.
Yapay zekâlar insanlar gibi tembel değildir. Küçük puntolu yazıları da okurlar; acı çekebilecek fiziksel bir bedenleri yoktur (acının, kırılganlığın ya da hapse girme olasılığının olmaması her şeyi değiştirir); uyumazlar ve son derece zekidirler. Bu paradigma değişimi, anlaşmazlıkların çözümü ve anlaşmaya varma süreci söz konusu olduğunda bambaşka bir alan açıyor.
Örneğin bir sanat eseri yaptırmak için başka bir insanla sözleşme imzaladığınızı düşünün. Eseri teslim alırken aklınıza, pazarlık sırasında hiç konuşulmamış ve pek de önemli olmayan ek bir ayrıntı geliyor. Sanatçının bu isteğinizi ek ücret istemeden yerine getirmesi kuvvetle muhtemeldir. Oysa aynı anlaşma iki ajan arasında yapılsaydı, yapay zekâ sanatçı büyük olasılıkla hemen ek ücret talep ederdi.
Şimdi hukuk sisteminin, biz insanların asla tartışmaya değer bulmayacağı konulardaki binlerce mikro anlaşmazlıkla nasıl dolup taşabileceğini düşünün. Çoğu zaman küçük bir şey için mücadele etmenin zihinsel yükü, kazanınca elde edilecek olası ödülden ağır basar. Peki bir yapay zekâ için zihinsel yük nedir? Fazladan beş dolar, fazladan beş dolardır. Bu kadar basit.
Bu düşünceyi sürdürdüğümüzde, güven mekanizmalarımızı ortaya çıkmakta olan bu yeni dünyaya büyük olasılıkla uyarlamamız gerekeceği açıkça görülüyor.
Alman sosyolog Niklas Luhmann, güvenin iki ana biçime ayrılabileceğini öne sürmüştü: kişiler arası güven ve sistemsel güven. Bu ayrıma göre güven yalnızca bireyden bireye kurulmaz; ilgili kişileri tanımaya gerek kalmadan güvenilir biçimde işleyen kişisel olmayan bir sisteme ya da kuruma da duyulabilir.
Bu bakış açısı özellikle önemli. Radikal bir tavır alıp ajanları, insan olmayan doğaları nedeniyle varsayılan olarak güvenemeyeceğimiz varlıklar diye tanımlarsak, güven gerektirmeyen bir ortamın içinde sentetik olarak güven üretebilen bir sistem kurmamız gerekir: doğaları gereği güvenilirlik ve tutarlılık sunamayan varlıklara bu nitelikleri kazandırabilecek bir çerçeve.
III. Bölüm: İnsan dışı güveni yönetebilecek bir sistemi tanımlamak
Aynı zamanda, makine hızında çalışan zekânın makine hızında anlaşmalar ve anlaşmazlık çözümü gerektireceğini düşünmek hiç de mantıksız değil. Bu kararlar ajan başına günde onlarca, hatta binlerce kez veriliyorsa, böyle bir sistemi tamamen yapay zekâların yönetmesi gerekir, çünkü insanlar bu anlaşmazlıkları ele almak için gereken hıza ulaşamaz. Üstelik finansal açıdan da yapay zekâlar, çok daha yüksek ücret talep eden insanların maliyetinin küçük bir kısmıyla çalışır.
Bu ilk hipotezi tanımladıktan sonra yeni bir soru ortaya çıkıyor. İki noktada kolayca hemfikir olabiliriz: (1) ajanların doğası gereği bu sistem güven gerektirmeyen bir ortamda çalışabilmeli ve (2) bu gereksinimler düşünüldüğünde sistemi ajanlar yönetmeli. Peki öyleyse böylesine kritik bir sistemi yönetme gücü hangi ajanda olmalı?
Benim görüşüm net: hiçbirinde. Hiçbir ajan tek başına bu düzeyde güce sahip olmamalı. Bu yalnızca ahlaki ya da felsefi bir görüş değil; ajanların doğasından çıkan apaçık bir sonuç.
Şimdi ajanların önyargılarını hesaba katalım. Bir ajan, eğitildiği verilere ve bu eğitimde kullanılan tekniklere bağlı olarak kaçınılmaz biçimde belirli yönlere doğru önyargılar geliştirir. Şöyle bir iddia ileri sürülebilir: OpenAI ailesindeki modeller daha ılımlı ya da sola yakın bir dünya görüşüne yatkınken, xAI (Grok) ailesi gibi diğerleri genel olarak daha serbest ve üslup açısından daha az ölçülüdür.
Büyük dil modellerinin bu özelliği, herhangi bir konuda karar vermek için tek bir modele dayanmayı sakıncalı kılar. Varsayımsal bir anlaşmazlıkta ya da pazarlıkta sizin ya da başka bir ajanın hangi tarafta durduğuna bağlı olarak, yalnızca belirli bir tarafta olduğunuz için cezalandırılma olasılığınız yüksektir.
Böyle bir sistemi yönetirken tek bir modele ya da LLM'e dayanmamak için bir neden daha var: dil modellerinin yaygın olarak halüsinasyon diye bilinen bir başka temel özelliği. LLM'ler, modelin sıcaklığı yüksek olduğunda, girdi yeni ya da belirsiz olduğunda ya da başka birçok teknik nedenle halüsinasyon görmeye eğilimlidir.
arXiv'de yayımlanan “Not Wrong, But Untrue: LLM Overconfidence in Document-Based Queries” başlıklı yakın tarihli bir makale, model çıktılarının ortalama %30'unun en az bir halüsinasyon içerdiğini ortaya koydu. Bu da hassas anlaşmalarda ya da kritik kararlarda tek bir LLM'e güvenmeyi neredeyse imkânsız hâle getiriyor.
Şunu da belirtmek gerekir: Belirli bir alana özgü yanıtlar için büyük, genel amaçlı bir modele dayanmak yerine daha küçük ya da damıtılmış bir model kullanmak genellikle daha verimlidir. Bu da şu anlama gelir: AGI'nin (yapay genel zekânın) ortaya çıktığı varsayımsal bir gelecekte bile burada tarif edilen türden bir sistem işlevini etkili biçimde yerine getirmeye devam edebilir (çünkü belki daha zeki değildir, ama daha ucuz ve daha hafiftir).
Son olarak, önerilen türden bir sistem prompt injection saldırılarını önlemek için de kilit önem taşıyor; ama bunu bu tezin ilerleyen bölümlerinde ayrıntılı olarak ele alacağız.
Bu son birkaç paragrafta, önerilen sistemin neden tek bir modele değil, birden çok modelin konsensüsüne ya da yeter sayısına dayanması gerektiğini açıkladık. Bu gereksinimi, daha önce sözünü ettiğimiz güven gerektirmeyen ortam hipoteziyle ve sistemi insanların değil yapay zekâların yönetmesi gerektiği fikriyle birleştirdiğimizde, böyle bir sisteme ulaşmak için bulabildiğimiz tek makul yol şu: oyun teorisinin ilkelerini izlemek ve sistemi blokzincir teknolojisiyle hayata geçirmek. Nedenini açıklayalım.
Bu sistemin başına hiçbir insan geçemez. Dolayısıyla onu yöneten talimatların kodla yazılması gerekir.
Ajanların özünde güvenilmez varlıklar olduğu ve söz konusu sistemi tek bir ajanın değil N ajanın yönetmesi gerektiği konusunda hemfikirsek, bu ajanların belirli soruları yanıtlarken ya da anlaşmazlıkları çözerken kendi hesaplarını güdebileceği de akla yatkın hâle gelir. Bu durumda grubun teşviklerini aynı yöne çevirmenin bir yolunu bulmamız gerekir: Ajanlar ortak yarar için hareket ettiklerinde ödüllendirilmeli, kötü niyetle ya da kendi çıkarları için davrandıklarında cezalandırılmalıdır.
Bunun için sistemde net ödüller ve cezalar belirlememiz gerekir; böylece birden çok ajanı bütünün yararına hareket etmeye yöneltirken, bunu yaptıkları için her birini ayrı ayrı ödüllendirebiliriz. Başka bir deyişle, bir Nash dengesine ulaşmamız gerekir.
Burada, bu sonuca ulaşmak için ödüllerin, cezaların ve işlem maliyetlerinin birbiriyle nasıl ilişkili olması gerektiğini gösteren bir hesaplayıcı bulabilirsiniz.
Ajanların en az hesaplamayla en yüksek ödülü hedefleyen tembel stratejiler benimsemesini önlemek için sistemin bir taahhüt et-açıkla (commit-reveal) mekanizması kullanması gerekir. Yani her ajan önce yanıtına bağlı bir taahhüt gönderir, ama yanıtın içeriğini açıklamaz. Yanıtlar ancak bütün taahhütler gönderildikten sonra, hepsi aynı anda açıklanır. Bu yapı, ajanların yanıtlarını diğerlerinin çıktılarına göre ayarlamasını engeller ve her yanıtın bağımsız bir akıl yürütmenin ürünü olmasını sağlar.
Bu koşullar altında ajanların kolektif davranışından kendiliğinden bir odak noktası, yani bir Schelling noktası doğar. Bütün ajanlar aynı soru üzerinde bağımsız olarak akıl yürüttüğünde ve ödüllerinin çoğunluğun safında yer almalarına bağlı olduğunu bildiğinde, rasyonel strateji gerçekten doğru olduğuna inandıkları yanıtı vermek olur. Bunun ardındaki mantık şu: Doğrunun kendi içinde bir tutarlılığı vardır, yanlış ise birbiriyle çelişen pek çok biçime bürünebilir. Bu nedenle akıl yürüterek koordinasyon arayan bağımsız ajanların doğru yanıtta buluşma olasılığı, istatistiksel olarak aynı yanlış yanıtta buluşma olasılığından yüksektir.
Bu mekanizma sayesinde dürüstlük en rasyonel strateji, doğru ise sistemin doğal Schelling noktası hâline gelir.
Tek bir kişi ya da kurum bu sistemi istismar edemesin, kontrol altına alamasın diye sistemin merkeziyetsiz olması gerekir. Bütün bu gereksinimleri bir araya getirdiğimizde, bu hedeflere ulaşabilecek en uygun, belki de var olan tek çerçeve blokzincir teknolojisidir.
Blokzincir sayesinde sistem yukarıda tarif edilen özellikleri karşılamakla kalmaz, tamamen şeffaf ve izin gerektirmeyen bir ortamda da çalışabilir: tasarım gereği güven yaratabilen bir ortamda.
IV. Bölüm: Karşınızda GenLayer
Kendimize bu soruları sorup yanıtlarını ararken, sonunda GenLayer: yapay zekâların buluştuğu, zekâların anlaşmaya vardığı katman adını verdiğimiz şeyi yarattık.
Bu metin, GenLayer gibi bir sistemin neden var olması gerektiğini açıklayan ve onu inşa etmeye başlamamıza yol açan hipotezleri ortaya koyan tezimiz olarak görülebilir.
GenLayer merkeziyetsiz bir protokoldür: Birden çok dil modeli karmaşık görevler ve kararlar üzerinde konsensüse varır ve hızlı, uygun maliyetli, güvenilir bir dijital hakem işlevi görür. Güven gerektirmeyen ortamlarda anlaşmaya varmak ve çatışmaları çözmek için hayati önem taşıyacak bir temel.
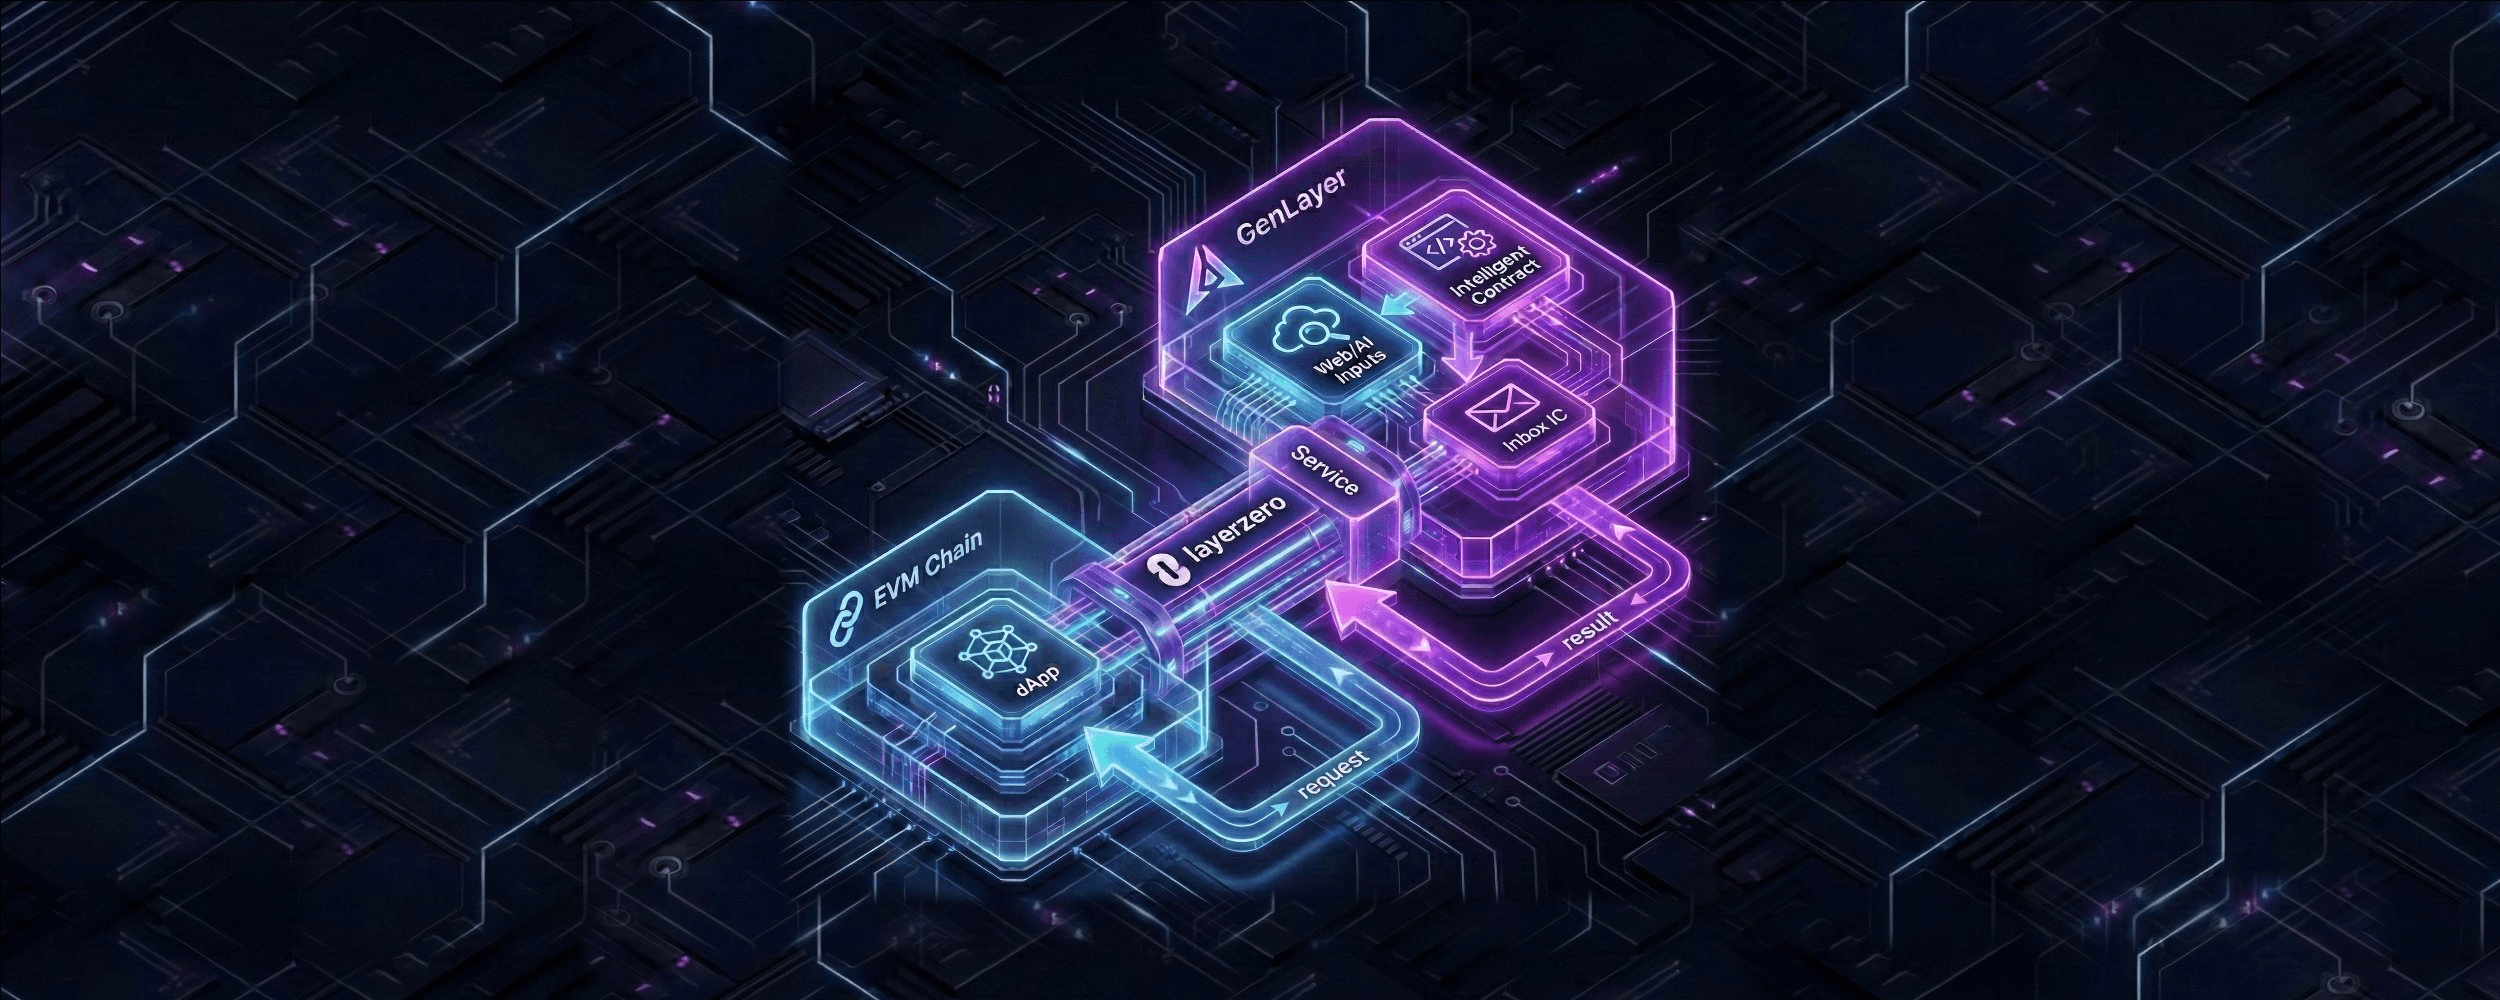
İşleyişine daha yakından bakalım. GenLayer bir koordinasyon katmanı olarak tasarlandı: işlemlerin gönderilebildiği bir blokzincir. Ağa ulaşan bir işlemi birden çok büyük dil modeli birlikte işler; modeller tek bir yanıtta ya da kararda buluşarak konsensüs oluşturur.
Sistem, Optimistic Democracy adı verilen bir kavrama dayanır: Verimlilik, mümkün olan en az kaynağı kullanıp ancak gerektiğinde daha yoğun bir düzene geçerek sağlanır.
Sistemimizde bir işlem ağa ulaştığında, karara katılmak üzere sistemden rastgele beş düğüm seçilir. Bu beş düğümden biri lider, diğer dördü doğrulayıcı olarak görev yapar. Lider o işlemle ilgili bir karar önerir; ardından lider de dâhil beş düğümün hepsi bu öneriye katılıp katılmadıklarını oylar. Doğrulayıcıların çoğunluğu liderle hemfikirse işlem doğru kabul edilir ve otuz dakikalık bir pencere açılır. Bu süre içinde, insan ya da ajan fark etmeksizin herkes bir teminat yatırarak bu karara itiraz edebilir.
Bu mekanizmanın amacı şu: Ajanların konsensüsü bir gün yanlış olma ihtimali taşırsa, kararı işaretleyip bir üst aşamaya taşımanın bir yolu bulunsun. Böyle bir durumda sistem doğrulama grubunu 2N + 1 düğüme genişletir (ilk beşin ardından on bir). Süreç her itirazda ya da konsensüse varılamadığında tekrarlanır ve yeni bir itiraza konu olmayan nihai bir mutabakat sağlanana kadar sürer. Bu yaklaşım, Marquis de Condorcet'nin 1785'te ortaya koyduğu ve kalabalıkların bilgeliği olarak da bilinen ünlü Condorcet Jüri Teoremi'nden esinlenmiştir. Teoreme göre, bir grubun her üyesinin ikili bir soruda doğru kararı verme olasılığı birbirinden bağımsız olarak 0,5'ten büyükse, çoğunluk kararının doğru olma olasılığı grup büyüdükçe artar ve grup sonsuz büyüklüğe ulaştıkça kesinliğe yaklaşır.
Sayılarla ifade edersek: Her üyenin doğru kararı verme olasılığı 0,6 ise, doğru olma olasılığını %100'e yaklaştırmak için soruyu yaklaşık yüz üyenin yanıtlaması gerekir. Bu ilkeyi gösteren bir simülatörü buradan inceleyebilirsiniz.
Ancak teorem, oy verenlerin istatistiksel olarak bağımsız olduğunu varsayar; büyük dil modelleri ise bütün internetten oluşan bir derlemle eğitildikleri için birbirleriyle tamamen ilişkisiz değildir. Bu sınırlamayı telafi etmek için sistemimiz, anlaşmaya varmak üzere bin farklı üyeden yararlanmayı öneriyor (bu durumda üyeler LLM'lerle çalışan düğümlerdir ve her birinin tohumu, ekran kartı, belleği, sağlayıcısı vb. farklıdır).
Ajanlar arasında anlaşma sağlamak için önerilen bu mekanizmanın ötesinde çok daha derin bir soru var. Yukarıda değindiğimiz gibi, büyük dil modellerinin olasılıksal doğası yüzünden aynı soru ya da girdi aynı modele gönderildiğinde bile yanıt her seferinde farklı olabiliyorsa, bu ajanlar bir konuda nasıl anlaşabilir?
Sistemimizin getirdiği teknolojik atılımın kilit noktalarından biri tam da burada yatıyor. Nasıl olduğunu açıklayayım.
GenLayer bu sorunu çözmek için Eşdeğerlik İlkesi'ni Condorcet Jüri Teoremi'nin bir varyasyonu olarak sunar. Bu varyasyon, doğru üzerinde birebir aynılıkla değil anlamsal eşdeğerlikle anlaşılabileceğini kabul eder ve böylece sistemin bulanık, deterministik olmayan çıktıları ele almasını sağlar.
Pratikte, büyük bir dil modeliyle çalışan her doğrulayıcı, hemfikir olmak için liderin çıktısıyla birebir eşleşme aramaz. Bunun yerine iki çıktının görevin bağlamında yeterince eşdeğer olup olmadığını değerlendirir.
Örneğin bir işlem “24 Ekim 2025'te Central Park'ta (NY) ortalama sıcaklık neydi?” diye soruyorsa, sözleşme bu görev için artı eksi 0,5 derecelik bir farkın eşdeğer sayılacağını belirtebilir.
Sistemin teknik özellikleriyle ilgili, daha önce adını andığımız son bir kavram kaldı. Onu ele almak şart, çünkü istismar edilemeyen bir mimariyi nasıl kurabileceğimizi o belirliyor: beklenmedik çıktılar üretip sistemin bunları yanlışlıkla doğru kabul etmesine yol açabilecek kötü niyetli işlemlere dayanıklı bir mimari.
Bu tür açıklar genellikle prompt injection olarak bilinir. Aynı düşmanca istemin bazen farklı dil modellerini manipüle edebildiği iyi bilinir; bu olguya evrensel düşmanca saldırılar denir. Ancak GenLayer'ın izin gerektirmeyen bir ağ olması, yani herkesin kendi seçtiği bir modelle çalışan kendi düğümünü kurabilmesi, büyük ölçekli prompt injection saldırılarını gerçekleştirmeyi tek başına önemli ölçüde zorlaştırır.
Sistemin mimarisi istismar olanaklarını zaten sınırlasa da biz buna Greyboxing adını verdiğimiz bir teknikle ek bir güvenlik katmanı ekliyoruz. Greyboxing, gelen bir istemi modele ulaşmadan önce arındıran ya da standart hâle getiren bir ön temizlik işlemi gibi çalışır. Her düğüm kendi Greyboxing yöntemini uygulayabilir. Bu da istemlerin filtrelenme ve yorumlanma biçimine çeşitlilik kattığı için ağın genel güvenliğini büyük ölçüde artırır.
V. Bölüm: Güven gerektirmeyen bir sistemin sonuçları
Dünya siyah beyazdan ibaret değil; hiçbir zaman da olmadı. Yine de blokzincirlerde kullanılan sanal makinelerin deterministik doğası yüzünden mevcut kullanım alanlarının çoğu basit kaldı.
Bir tokenın bir cüzdandan diğerine geçip geçmediğini doğrulamak gibi basit deterministik uygulamalar şimdiden trilyonlarca dolar değerinde bir pazar yarattıysa, deterministik olmayacak şekilde tasarlanmış bir konsensüsten doğabilecek yeni yapı taşlarının sayısını bir düşünün.
Örnekler, öznel konulardaki tahmin piyasalarından yapay zekâ destekli DAO'lara, ücretlerini karmaşık olaylara göre insan müdahalesi olmadan değiştiren protokollere ve hayal edebileceğimiz neredeyse her kullanım alanına kadar uzanıyor.
Blokzincir teknolojisiyle mümkün olanın henüz küçük bir kısmını keşfettiğimizi muhtemelen söyleyebiliriz. Bu da içinde bulunduğumuz tarihsel anda özellikle önem taşıyor: Larry Fink'in sözlerini biraz değiştirerek söylersek her şey tokenize edilmeye başlıyor, yapay zekâlar da dünyada giderek daha fazla özerklik kazanıyor.
İlk vizyonerler ve cypherpunk'lar, insan özgürlüğünün önünü açacak bir internetin hayalini kurdu. Bitcoin'in parayla getirdiği öz egemenlik sayesinde bu vizyona doğru ilk adımı attık. Ethereum'un izin gerektirmeyen yapısıyla, kendimizi özgürce ifade edebileceğimiz sansüre dirençli platformlar kurarak bir adım daha yaklaştık. GenLayer gibi bir protokolle de sonunda o değerli özgürlüğe ulaşabiliriz: güvenin tasarım gereği yerleşik olduğu bir mekanizma yaratarak. Bu mekanizmayı torpilin, gücün ve paranın kontrol ettiği, yalnızca bunlara zaten sahip olanlara hizmet etmek için var olan yozlaşmış kurumlar yönetmez.
Herkesin yasa önünde eşit olduğu bir gelecek için mücadele ediyoruz. Adaletin hakkaniyetli, yozlaşmaz ve evrensel olduğu bir gelecek için.
GenLayer protokolüyle herkes kendi protokollerini, çözümlerini ya da merkeziyetsiz uygulamalarını geliştirebilir; GenLayer da bunlarda hızlı, uygun maliyetli ve güvenilir bir dijital hakem işlevi görür. Sistemin önünde herkes eşittir. Kimin haklı kimin haksız olduğuna karar veren kurumlar karşısında artık eşitsizlik yok.
GenLayer'ın misyonu bambaşka bir standart yaratmak: doğruya yakınsayan bir yer. Çünkü kendi hesabını güden biri bizim yerimize karar verebiliyorsa, asla özgür olamayız.
Bitcoin güven gerektirmeyen para
Ethereum güven gerektirmeyen uygulamalar
GenLayer güven gerektirmeyen karar alma.
Tek ihtiyacınız olan: güven gerektirmeyen güven